La scansione che pensa come un motore generativo.
Non è un altro spider qualunque. Un crawler con rendering JS che rispetta robots.txt, segue i canonical e registra ogni codice di stato, redirect e link interno — esattamente quello che fa il bot di ChatGPT o Perplexity quando decide se citarti.
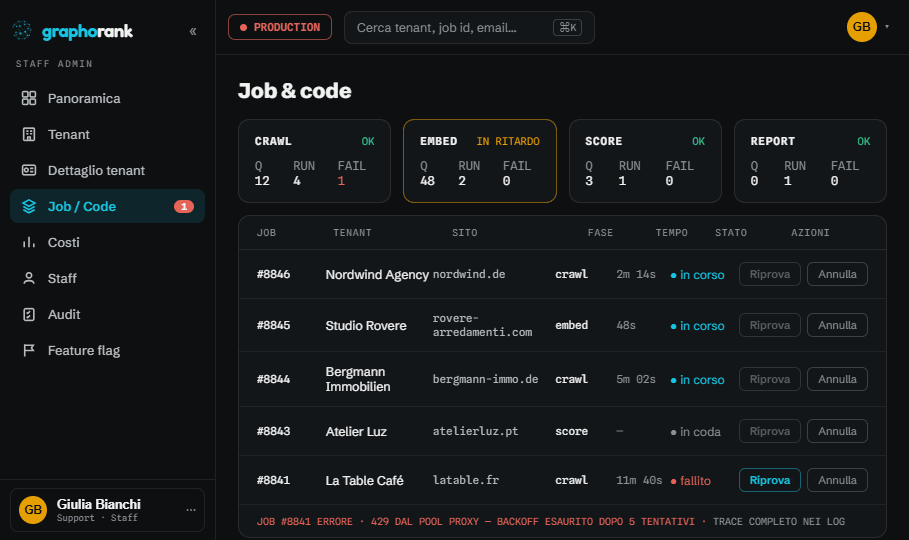
Se il crawler generativo si perde tra redirect e JavaScript non renderizzato, nella risposta non esisti. Ti mostriamo esattamente dove si perde.
Cosa cattura, pagina per pagina
Rendering reale
Eseguiamo JavaScript come farebbe un browser: vediamo la pagina esattamente come la vede il motore, non l’HTML grezzo.
Grafo dei link
Ogni link interno che il crawler segue diventa un arco nel grafo: profondità, canonical, redirect.
Quota rispettata
Il crawler rispetta il tuo piano e le regole di robots.txt. L’audit gratuito copre le prime 10 pagine.
Cosa tiene davvero un agente AI di una pagina
Un agente non vede il tuo layout. Scarica l’HTML, butta via tutto ciò che non è contenuto e risponde con quello che resta. Ecco la home di questo sito, contata — nella lingua in cui la stai leggendo.
3,5%della nostra home è testo che un agente può leggere — 4,7 kB su 134,2 kB di HTML.
Cosa tiene
- Parole di testo leggibile
- 809
- Titoli (H2, H3)
- 8
- Link che può seguire dal testo
- 13
- Tipi di dati strutturati
- 5
Dati strutturati trovati:AnswerFAQPageOrganizationQuestionWebSite
Cosa scarta
- Link di menu e footer
- 55
- Grafica inline
- 11
- Script
- 10
- Markup e stili
- 129,5 kB
Non è spreco: menu, grafica e script sono ciò che rende la pagina usabile per una persona. Semplicemente non sono ciò da cui un agente ricava la risposta.
Conteggi fatti sulla home di questo sito in fase di build. Nessuna stima: se la pagina cambia, cambiano anche questi numeri.
Leggi anche:Analisi semantica · Grafo semantico · Navigabilità agentica e citabilità
Avvia la tua prima scansione
Dacci un dominio — in due minuti vedrai come lo attraversa un motore.