De crawl die denkt als een generatieve zoekmachine.
Niet zomaar een spider. Een crawler met JS-rendering die robots.txt respecteert, canonicals volgt en elke statuscode, redirect en interne link vastlegt — precies wat een bot van ChatGPT of Perplexity doet bij de beslissing of hij je citeert.
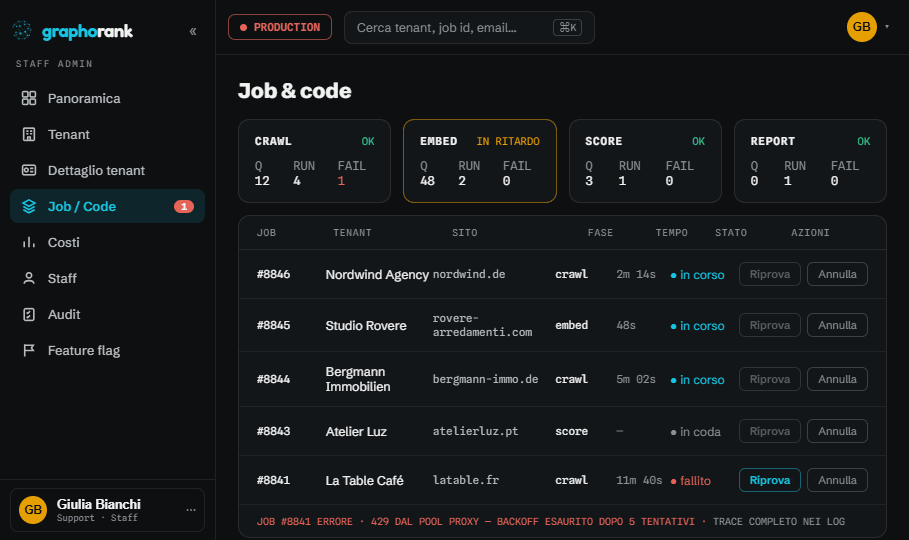
Als de generatieve crawler verdwaalt in redirects en niet-gerenderde JavaScript, besta je niet in het antwoord. Wij laten je precies zien waar hij verdwaalt.
Wat hij vastlegt, pagina voor pagina
Echte rendering
We voeren JavaScript uit zoals een browser dat doet: we zien de pagina zoals de zoekmachine hem echt ziet, niet de ruwe HTML.
Linkgrafiek
Elke interne link die de crawler volgt wordt een edge in de grafiek: diepte, canonicals, redirects.
Quotum gerespecteerd
De crawler volgt je plan en de robots-regels. De gratis audit dekt de eerste 10 pagina’s.
Wat een AI-agent echt overhoudt aan een pagina
Een agent ziet je opmaak niet. Hij haalt de HTML op, gooit alles weg wat geen inhoud is en antwoordt met wat overblijft. Dit is de homepage van deze site, geteld — in de taal waarin je dit leest.
3,5%van onze homepage is tekst die een agent kan lezen — 4,7 kB van 134,2 kB HTML.
Wat hij overhoudt
- Woorden leesbare tekst
- 753
- Koppen (H2, H3)
- 8
- Links die hij vanuit de tekst kan volgen
- 13
- Typen gestructureerde data
- 5
Gevonden gestructureerde data:AnswerFAQPageOrganizationQuestionWebSite
Wat hij weggooit
- Links in menu en footer
- 55
- Inline graphics
- 11
- Scripts
- 10
- Markup en opmaak
- 129,5 kB
Geen verspilling: menu’s, graphics en scripts maken de pagina bruikbaar voor een mens. Ze zijn alleen niet waar een agent zijn antwoord uit haalt.
Geteld op de homepage van deze site tijdens de build. Niets is geschat: verandert de pagina, dan veranderen deze getallen mee.
Lees verder:Semantische analyse · Semantische grafiek · Agentische navigeerbaarheid en citeerbaarheid
Start je eerste crawl
Geef een domein op — over twee minuten zie je hoe een zoekmachine er doorheen loopt.